public enum StoreCode {

    BR(Language.pt_BR, Subdomain.BR, Language.pt_BR, Language.en),
    US(Language.en_US, Subdomain.WWW, Language.en_US)
    // ....
    ;

    private final Language defaultLanguage;
    private final Language [] supportedLanguages;
    private final Subdomain subdomain;

    StoreCode(Language defaultLanguage, Subdomain subdomain, Language ... supportedLanguages) {
        this.defaultLanguage = defaultLanguage;
        this.subdomain = subdomain;
        this.supportedLanguages = supportedLanguages;
    }

    public Language getDefaultLanguage() {
        return defaultLanguage;
    }

    public Subdomain getSubdomain() {
        return subdomain;
    }

    public Language[] getSupportedLanguages() {
        return supportedLanguages;
    }
}
lunes, 14 de marzo de 2016
Enums: Campos de arreglo
Usando arreglos en campos del enum. En este ejemplo utilizado para agragar los lenguajes soportados por una tienda.

viernes, 12 de febrero de 2016
Enums: Buscando valores de manera invertida
Un tip interesante para simplificar la búsqueda en un enum por alguna de sus propiedades. En este ejemplo tenemos un enum para tiendas de países. Una de sus propiedades es el subdominio. Si queremos tener un método para retornar el valor de la tienda usando como entrada el subdominio, podemos preparar un mapa de manera estática donde la llave es el subdominio.
public enum CountryStore {

    AD(Language.en, Measures.METRIC, Subdomain.AND),
    AE(Language.en, Measures.METRIC, Subdomain.AE),
    AF(Language.en, Measures.METRIC, Subdomain.AF),
    ...

    private final Language defaultLanguage;
    private final Measures defaultMeasure;
    private final Subdomain subdomain;

    CountryStore(Language defaultLanguage, Measures defaultMeasure, Subdomain subdomain) {
        this.defaultLanguage = defaultLanguage;
        this.defaultMeasure = defaultMeasure;
        this.subdomain = subdomain;
    }

    private final static Map<String, StoreCode> subdomainMap;

    static {
        // Reverse lookup preparation for subdomains.
        Map<String, CountryStore> smap = new HashMap<String, CountryStore>();

        for(CountryStore store: CountryStore.values()) {
            smap.put(store.getSubdomain().name().toLowerCase(), store);
        }
        subdomainMap = Collections.unmodifiableMap(smap);
    }

    public static CountryStore fromSubdomain(String subdomain) {
        return subdomain == null ?  null :  subdomainMap.get(subdomain.toLowerCase());
    }

}
viernes, 18 de septiembre de 2015
Programación Reactiva: Reactive Extensions Library o RX (comenzado a aprender esta cosa de Reactive)
Encontré un buen video explicando la programación reactiva en el sabor de la librería
Reactive Extensions hecho por Jafar Husain (Líder técnico en
Netflix) .
Aquí un pequeño resumen de los principales conceptos que extraje.
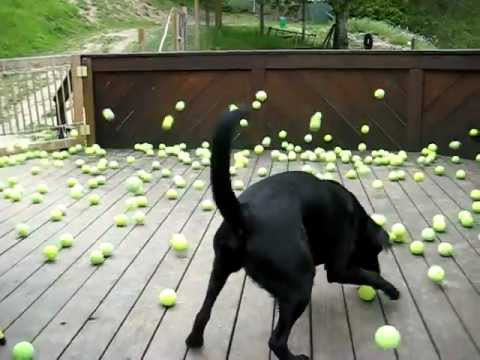
El término reactivo se puede asociar por analogía con alguien tirando un montón de bolas hacia uno
al mismo tiempo. Tienes que reaccionar rápidamente para tratar de atraparlas todas. Uno no tiene control sobre cuándo quiere
que las pelotas sean lanzadas, sólo hay que estar preparado para la captura de ellas.
Para empezar a entender Rx (Reactive Extensions), necesitamos tener en mente dos patrones
fundamentales de diseño en consideración: Iterador y Observador.
En Java tenemos la interfaz Iterable, que es una interfaz que
cualquier tipo de colección puede implementar para permitir a los consumidores de esa colección obtener objetos uno a la vez. Así es como en Java
podemos utilizar el operador foreach para recorrer una colección. Debido a que la interfaz proporciona un específico Iterator para el tipo de datos que estamos consumiendo
en la colección.
Tres cosas pueden pasar cuando usamos un iterador:
Tres cosas pueden pasar cuando usamos un iterador:
- Obtener el siguiente item
- No hay más items para consumir (fin del flujo de datos)
- Un error sucedió (en Java mediante el uso de excepciones)
El patrón Obervador es otro famoso patrón de diseño donde subscriptores se subscriben a ciertos temas para poder ser
notificados cuando un cambio ocurre. Si analizamos este patrón encontramos que es muy similar al patrón Iterador
en el sentido que existe un productor y un consumidor; la principal diferencia es que en el Observador el productor
está en control de cuando enviar los datos, mientras que en el Iterador el consumidor es el que está en control. El
es el que decide cuando tomar los datos del productor.

Pero hay dos aspectos principales "ausentes" del patrón Observador que si están presentes en el patrón Iterador:
- Una manera de indicar que no hay más datos
- Una manera de indicar que un error acaba de suceder
En el Observador uno solamente puede subscribir un callback para recibir datos, pero no puede registrar callbacks
para el evento donde se indica que no hay más datos siendo encolados en el stream (evento de completado), o para
indicar que un error sucedió. RX trata básicamente de unificar el "acueducto" del Observador con el "acueducto" del Iterador
produciendo un nuevo tipo llamado el Observable, el cual proporciona la misma semántica de ambos patrones.
Hay un montón de operaciones interesantes que se pueden realizar sobre los iterables. En SQL existen un gran número de operaciones que se pueden hacer sobre conjunto de datos: filtrar, seleccionar, ordenar,
etc. Que tal si todas esas mismas operaciones que podemos ejecutar sobre datos alojados en una tabla, pudiéramos también
hacerlo sobre eventos (datos que llegan). Eso no es una fantasía con RX. Es posible escribir sentencias al estilo SQL
sobre eventos. La diferencia es que la consulta es evaluada conforme llegan los datos. Uno puede evaluar datos en
tiempo real.
Cada vez más el código se esta volviendo orientado a eventos. Tenemos un montón de llamadas asincrónicas en el lado
del cliente (JS), y del lado del servidor (Node.JS). Esto agrega mucha complejidad en la aplicación que intenta
manejar todos estos callbacks. RX provee el nuevo tipo de datos Observable
para establecer una manera poderosa de modelar eventos. Al completar las semánticas faltantes (fin de flujo de datos y
error), ahora uno puede aplicar operaciones familiares que hacemos sobre colecciones como map, filter, reduce, merge, zip, etc.
Todas estas cosas podemos hacerlas sobre flujo de datos también.
Imaginemos la nueva Java 8 Stream API sobre datos que llegan dinámicamente por eventos lanzados hacia uno.
Muchas cosas pueden mejorar en la aplicación como enviar datos al consumidor mucho más rápido, por citar solo
un ejemplo.
Aún necesito aprender mucho más de este nuevo paradigma, pero al menos pienso que este video cubre los conceptos fundamentales que necesitamos tener de antemano antes de arrojarnos a jugar con RX en el código.
Aún necesito aprender mucho más de este nuevo paradigma, pero al menos pienso que este video cubre los conceptos fundamentales que necesitamos tener de antemano antes de arrojarnos a jugar con RX en el código.
miércoles, 24 de junio de 2015
¿Es esto arquitectura?

Interesante artículo de Gregor Hohpe que nos enseña por analogía lo que una documentación de una arquitectura de Software debería contener. Muy resumidamente, una descripción de arquitectura de Software debería mostrar decisiones no triviales u obvias hechas en un sistema. Por ejemplo, describir que en el sistema hay una separación de capa de presentación (Front-End) con la capa de datos (Back-End), es lo mismo que decir que en una casa tenemos puertas que tocan el piso para que la gente pueda caminar por ellas.
Quizás determinar que es trivial y qué no lo es puede despertar sospechas de que estamos en terreno de lo subjetivo, pero creo que a como maduramos como desarrolladores de software, y vamos obteniendo experiencia observando patrones recurrentes en los diseños de sistemas en los que participamos, se va volviendo un poco más claro cuando algo es digno de ser documentado. Esto se nota también en el plano del código de programación cuando intentamos que el mismo sea auto-descriptivo y solo comentamos lo que no parece obvio de entender.
viernes, 5 de junio de 2015
Apache2: Configurar una página local con Host personalizado/customizado (Virtual Host)
1. Crear la carpeta /wwww/domain
sudo mkdir -p /www/domain
2. Cambiar permisos
sudo chown 755 /www/domain sudo chown -R www-data:www-data /www/domain
3. Editar Apache2 conf
sudo gedit /etc/apache2/apache2.conf Agregar estas líneas:
4. Agregar una entrada en /etc/hosts
127.0.0.1 gabo.com
5. Create el archivo html para prueba
touch /wwww/domain/index.html Con cualquier código HTML:
6. Abrir dominio gabo.com en el navegador.
sudo mkdir -p /www/domain
2. Cambiar permisos
sudo chown 755 /www/domain sudo chown -R www-data:www-data /www/domain
3. Editar Apache2 conf
sudo gedit /etc/apache2/apache2.conf Agregar estas líneas:
<VirtualHost *:80>
    # This first-listed virtual host is also the default for *:80
    ServerName gabo.com
    ServerAlias gabo.com
    DocumentRoot /www/domain
</VirtualHost>

<Directory /www/domain/>
    Options Indexes FollowSymLinks
    AllowOverride None
    Require all granted
</Directory>
4. Agregar una entrada en /etc/hosts
127.0.0.1 gabo.com
5. Create el archivo html para prueba
touch /wwww/domain/index.html Con cualquier código HTML:
<http>
<body>
<h1>Hello!</h1>
</body>
</http>
6. Abrir dominio gabo.com en el navegador.
viernes, 12 de diciembre de 2014
Spring Web: Obtener request actual y generar URL de la aplicación
Una forma sencilla de generar el URL base acorde con el contexto de ambiente de la aplicacion a partir del objeto request:
protected static String getBaseEnvLinkURL() {

   String baseEnvLinkURL=null;
   HttpServletRequest currentRequest =
      ((ServletRequestAttributes)RequestContextHolder.currentRequestAttributes()).getRequest();
   baseEnvLinkURL = "http://" + currentRequest.getLocalName(); // lazy about determining protocol
   if(currentRequest.getLocalPort() != 80) {
      baseEnvLinkURL += ":" + currentRequest.getLocalPort();
   }
   if(!StringUtils.isEmpty(currentRequest.getContextPath())) {
      baseEnvLinkURL += currentRequest.getContextPath();
   }
   return baseEnvLinkURL;
}
jueves, 13 de noviembre de 2014
Ubuntu: Resolviendo problema de instalación con aptitude
Tratando de instalar el reproducto VLC en mi Ubuntu Linux 14 me daba este error usando el comando:
sudo apt-get install vlc
Some packages could not be installed. This may mean that you have
requested an impossible situation or if you are using the unstable
distribution that some required packages have not yet been created
or been moved out of Incoming.
The following information may help to resolve the situation:
The following packages have unmet dependencies:
vlc : Depends: vlc-nox (= 2.2.0~rc1-1ppa1~trusty) but it is not going to be installed
Depends: libavcodec56 (>= 7:2.4~) but it is not going to be installed
Recommends: vlc-plugin-notify (= 2.2.0~rc1-1ppa1~trusty) but it is not going to be installed
Recommends: vlc-plugin-samba (= 2.2.0~rc1-1ppa1~trusty) but it is not going to be installed
E: Unable to correct problems, you have held broken packages.
Después de intentar muchos comandos para limpiar los paquetes quebrados, finalmente instalé aptitude y corrí el comando:
sudo aptitude install vlc
Y listo, todos mis problemas de paquetes los resolvió aptitude y pude instalar mi reproductor favorito.
sudo apt-get install vlc
Some packages could not be installed. This may mean that you have
requested an impossible situation or if you are using the unstable
distribution that some required packages have not yet been created
or been moved out of Incoming.
The following information may help to resolve the situation:
The following packages have unmet dependencies:
vlc : Depends: vlc-nox (= 2.2.0~rc1-1ppa1~trusty) but it is not going to be installed
Depends: libavcodec56 (>= 7:2.4~) but it is not going to be installed
Recommends: vlc-plugin-notify (= 2.2.0~rc1-1ppa1~trusty) but it is not going to be installed
Recommends: vlc-plugin-samba (= 2.2.0~rc1-1ppa1~trusty) but it is not going to be installed
E: Unable to correct problems, you have held broken packages.
Después de intentar muchos comandos para limpiar los paquetes quebrados, finalmente instalé aptitude y corrí el comando:
sudo aptitude install vlc
Y listo, todos mis problemas de paquetes los resolvió aptitude y pude instalar mi reproductor favorito.
martes, 4 de noviembre de 2014
Herramienta para captura y edición de capturas de pantalla (screenshots)
Tenía la necesidad de agregar unas flechas a unas capturas de pantalla usando mi Ubuntu. Intenté hacerlo con Gimp pero resultó más complicado de lo que pensaba. Así que instalé está recomendación: http://shutter-project.org/.
Se puede instalar con el comando: sudo apt-get install shutter

martes, 9 de septiembre de 2014
ORA-28002: the password will expire within X days
Para un ambiente de desarrollo normalmente no es importante que las contraseñas de base de datos expiren. Me estaba dando ese mensaje de que mi contraseña para el usuario 'system' iba a expirar. Así que para evitar esto en el futuro y dejar la misma contraseña, ejecuté los siguientes comandos:
SQL> ALTER PROFILE DEFAULT LIMIT PASSWORD_LIFE_TIME UNLIMITED;
SQL> ALTER USER SYSTEM IDENTIFIED BY <password>;
martes, 3 de junio de 2014
GREP tips
Solamente coleccionando magia grep
Busque ocurrencia de manera recursiva en el directorio actual, ignorando mayúsculas/minúsculas (case) y cuente el número de líneas.
grep -Ri "search_term" . | wc -l
Agrupa las ocurrencias de un path en el web-access log y cuenta las ocurrencias.
grep -Eo "/wrapper-app-api(/\w+/\S*)" web-access.log | sort | uniq -c
3056 /wrapper-app-api/internal/graphitedump
146635 /wrapper-app-api/internal/health.check
152045 /wrapper-app-api/wrapper/community
27183 /wrapper-app-api/wrapper/csrf
37473 /wrapper-app-api/wrapper/get
134 /wrapper-app-api/wrapper/left/all-writers
1 /wrapper-app-api/wrapper/left/exercises
4 /wrapper-app-api/wrapper/left/food-and-recipes
2 /wrapper-app-api/wrapper/left/gethinmusclenutrition
2 /wrapper-app-api/wrapper/left/Mind
2 /wrapper-app-api/wrapper/left/Nutrition
11 /wrapper-app-api/wrapper/left/root
7 /wrapper-app-api/wrapper/left/Supplements
135 /wrapper-app-api/wrapper/left/Training_Main
204 /wrapper-app-api/wrapper/locale
35 /wrapper-app-api/wrapper/notstore
593 /wrapper-app-api/wrapper/proxy.html
martes, 15 de abril de 2014
Java: URL de archivo localizado en el classpath
Una manera de averiguar el URL de un archivo localizado en el classpth (útil en casos como tests de unidad de classes que consumen datos por la web):
getClass().getClassLoader();
String url = ClassLoader.getSystemResource("path/to/file").toString();
miércoles, 9 de abril de 2014
Eclipse Maven: 'Updating Maven Project' has encountered a problem.

An internal error ocurred during 'Updating Maven project'.
java.lang.NullPointerException
De repente comencé a tener este error con uno de mis proyectos de Maven. La mejor solución que encontré fue:
- Borrar el proyecto de Eclipse (no los archivos)
- Borrar el .project y el .settings/ del proyecto
- Re imporar el proyecto
- Convertirlo a un proyecto Maven
martes, 18 de marzo de 2014
MongoDB Tips
Actualizar todos los documentos de una colección para agregar un nuevo campo:
db.<COLLECTION>.update({}, {$set: {<NEW_FIELD>:<VALUE>} }, {multi:true})Renombrar el nombre de una columna/campo
db.<COLLECTION>.update({}, {$rename: {'<OLD_FIELD_NAME>': '<NEW_FIELD_NAME>'}}, false, true);Exportar/Importar una colección
mongoexport -d <DATABASE> -c <COLLECTION> -o <FILE_PATH>mongoimport -d <DATABASE> -c <COLLECTION> --file <FILE_PATH>
Remover una columna/atributo en todos los documentos de la colección
db.<COLLECTION>.update({}, {$unset: {<FIELD>:""} }, {multi:true})Consultar todos los documentos donde un arreglo tiene tamaño mayor a 0
db.<COLLECTION>.find({ $where: "this.FIELD.length > 1" } )Consultar por tamaño de un arreglo mayor a n
db.getCollection(<COLLECTION>).find({ $where: "this.<ARRAY_FIELD>.length > 8" })
viernes, 14 de marzo de 2014
Log4j: Tips
Cambiar el nivel de log para un paquete o clase
En el log4j.properties:log4j.rootLogger=INFO,Stdout
log4j.logger.
SLF4J: Multiple bindings were found on the class path logback
En el proyecto que estoy trabajando utilizamos SLF4J como framework de logging. Estaba teniendo un problema en el cual mis llamados para registrar entradas en el log no estaban apareciendo. Al principio pensé que era un problema con el archivo de log4j ya que esta era la implentación final que se estaba utilizando. Sin embargo luego me dí cuenta de unos mensajes apareciendo al principio del arranque de la aplicación:
SLF4J: Class path contains multiple SLF4J bindings.
SLF4J: Found binding in [jar:file:/home/atg-dev/.m2/repository/ch/qos/logback/logback-classic/0.9.28/logback-classic-0.9.28.jar!/org/slf4j/impl/StaticLoggerBinder.class]
SLF4J: Found binding in [jar:file:/home/atg-dev/.m2/repository/org/slf4j/slf4j-log4j12/1.6.2/slf4j-log4j12-1.6.2.jar!/org/slf4j/impl/StaticLoggerBinder.class]
SLF4J: See http://www.slf4j.org/codes.html#multiple_bindings for an explanation.
2014-03-13 21:30:46.718:INFO:/search-indexer:Initializing Spring root WebApplicationContext
Los mensajes estaban indicando que habían varios bindings, es decir, varias implementaciones de logging dentro del classpath. En específico pude ver que aparte de Log4j estaba LogBack, el cual no encontré ninguna referencia en el pom.xml. Había que descubrir la dependencia indirecta/transitiva.
La mejor manera para hallar la dependencia transitiva fue una idea de un compañero de utilizar el plugin de Maven en Eclipse que permite ver la jerarquía de dependencias.

De esa manera pude ubicar la dependencia que incluía al logback y agregar la exclusión:
        <dependency>
            <groupId>com.xxx.content</groupId>
            <artifactId>content-dao-jar</artifactId>
            <version>xx.xx.x.x</version>
            <exclusions>
                <exclusion>
                    <groupId>ch.qos.logback</groupId>
                    <artifactId>logback-classic</artifactId>
                </exclusion>
            </exclusions>
        </dependency>
martes, 11 de marzo de 2014
Git: Lista de comandos útiles
Revertir cambios locales del branch al contenido remoto
git reset --hard origin/<branch>Fusionar branch2 en branch1
git checkout branch1git merge branch2
Enviar un branch local al servidor remoto
git push origin brancMostrar branches locales
git branchBorrar branch remoto
git push origin --delete branchname
Borrar branch local
git branch -D the_local_branch
jueves, 6 de marzo de 2014
JMeter: Primeros pasos probando rendimiento de aplicaciones web
Una gran herramienta en la caja de herramientas de todo buen desarrollador de software, es aquella que te permite evaluar el rendimiento de una aplicación. En el caso de aplicaciones web es extremadamente necesario hacer estas pruebas de rendimiento simulando una alta concurrencia de usuarios debido a la naturaleza concurrente de la web.
Una gran herramienta open source para realizar este tipo de pruebas se llama JMeter de Apache. Con ella puedo crear múltiples solicitudes a una dirección web y medir la respuesta para examinar el compartamiento en términos de rendimiento.

Pasos para crear un plan de pruebas sencillo:
- Descargar JMeter del sitio web oficial de Apache. En Ubuntu se puede instalar usando el comando: apt-get install jmeter
- Agregue un Thread Group al Test Plan: Clic derecho en el test plan ->Add->Threads (Users)->Thread Group

- Edite los campos del Thread Group como el número de usuarios y la cantidad de ciclos, entre otros.

- Agregamos un HTTP Request: Clic derecho en el Thread Group->Add->Sampler->HTTP Request
- Editamos los campos requeridos de acuerdo al tipo de request

- Agregamos un listener de acuerdo al tipo de reporte que desemos: Clic derecho en Test Plan->Add->Listener->Graph Results
- Damos Start y observamos nuestro gráfico crecer


- Interpretamos los resultados y/o ajustamos el plan para obtener la información que requerimos
miércoles, 12 de febrero de 2014
Tridion y sus bloques de construcción
Siempre es bueno guardar conceptos claves de las tecnologías que uno ha usado en el pasado. El aprender a reconocer debilidades y fortalezas de una tecnología es vital para desarrollar un criterio ingenieril o arquitectural que nos ayuda a tomar mejores decisiones técnicas.
Hace un tiempo trabajé con un administrador de contenido propietario llamado Tridion de SDL. Sinceramente no me agradó mucho por algunas razones que no vienen al caso mencionar ahora, pero hubieron varios conceptos que me agradaron y que comentaré brevemente en algunas entradas de blog.
Unos de los conceptos que me llamó la atención es la manera muy clara en que separan el contenido de la presentación, y como lo hacen de una manera escalonada por medio de sus "bloques de construcción". Esta separación es sumamente importante en un buen administrador de contenido o CMS (Content Management System). Es altamente deseable que el contenido en un sistema de contenido se pueda preservar mientras su presentación evoluciona con el tiempo adaptando las nuevas tendencias de presentación web.
Esta facilidad permite también una excelente separación de roles donde tenemos editores de contenido que no se preocupan porque el contenido luzca agradable, y por otra parte los diseñadores web que maquillan el sitio web acorde a las tendencias de moda.
En organizaciones muy grandes, esta característica permite además imponer una serie de formatos, y/o plantillas para mantener uniformidad en sitios (o gama de sitios) web grandes y complejos donde muchas personas editan contenido.
La manera en que lo hace Tridion es definiendo los siguientes bloques de construcción de páginas web.
Los esquemas (schemas) definen los metadatos de un componente como lo son los nombres de los campos, sus tipos y si son mandatorios o no. En el ejemplo graficado abajo se muestra un esquema de comida con campos como título y subtítulo de tipo texto, y imagen de tipo imagen.
Luego un componente (component) es como la instancia de un esquema. Es decir, llenar los campos de un esquema con valores específicos. En el ejemplo se llena el esquema de comida con datos de una pizza.
La plantilla del componente (component template) viene a definir la disposición y estilos básicos de los distintos campos del componente. Un componente podría disponer de diferentes plantillas de acuerdo a las distintas necesidades de presentación. Por ejemplo, en el gráfico se muestra una alineación hacia la derecha de la imagen de la comida con el título y subtítulo encabezando a la izquierda, seguidamente del cuerpo del texto. Uno podría disponer otra plantilla que quizás se utilice para resultados de búsquedas donde la imagen se omite y solo se muestra el título con el texto de la descripción de la comida truncado.
La plantilla de la página (page template) establece los elementos globales de una plantilla web particula. Típicos casos de menús de navegación, encabezados, pies de página, etc.
La presentación del componente (component presentation) es la unión de un componente particular con una plantilla de componente. El resultado final es la presentación del contenido del componente en su forma agradable para el usuario.
Finalmente cuando se une la plantilla de la página con uno o más componentes de presentación tenemos finalmente una página web (web page).

Sin duda esta separación de contenido y presentación implica mucho trabajo al inicio con la definición de esquemas, plantillas y componentes, pero la retribución final es satisfactoria al explotar la gran flexibilidad que se alcanza con este modelo.
viernes, 8 de noviembre de 2013
Ubuntu: Creando y reintegrando un archivo tar multi-partes
Necesitaba guardar una máquina virtual en mi disco duro externo y me di cuenta que lo tenía formateado en FAT32, por lo cual no podía guardar un archivo mayor a 4GB.
tar -cvf - myVM.vdi | split --bytes=4000m --suffix-length=4 --numeric-suffix - MyVM.tar.
Para reintegrarlo:
cat MyVM.tar.* | tar xvf -
miércoles, 6 de noviembre de 2013
ATG Colorizer: libstdc++.so.6: cannot open shared object file: No such file or directory
Estaba en medio de mi configuración inicial de desarrollo de ATG y comenzé a tener problemas con una pequeña aplicación llamada ATG Colorizer.
Me daba el siguiente error:
libstdc++.so.6: cannot open shared object file: No such file or directory
Intenté instalar la librería como lo había hecho antes, pero parecía que mi nuevaversión de Ubuntu no reconocía la receta antigua de instalación.
Así que después de buzear un rato por Internet encontré una manera que sí le gustó a mi Ubuntu:
apt-get install lib32stdc++6
Suscribirse a:
Entradas (Atom)